近日,由电子科技大学、成都信息工程大学、中国电信云计算研究院联合完成的研究成果《When Reinforcement Learning Meets Zero-Determinant: Social Welfare Control in Iterated Game under Spatial Crowdsourcing》,被计算机体系结构与并行分布式计算领域CCF A类顶级学术期刊IEEE TPDS正式录用。
科研团队在中国电信首席科学家、云计算研究院院长吴杰教授的指导下开展研究,核心成员包括电子科技大学顾记清博士(现任职于成都信息工程大学)、宋超副教授、鲁力教授和刘明教授。
空间众包是物联网时代的典型感知模式,依托海量移动设备的分布式传感器能力,可实现城市环境监测、交通信息采集、公共服务分发等广泛应用。在完整的空间众包体系中,众包平台负责调度感知任务,网络服务商通过路侧通信单元提供数据传输能力,双方多轮独立决策、相互影响,构成了典型的迭代博弈场景,博弈策略直接决定了整个系统的数据服务质量与整体运行效益。
传统基于强化学习的博弈优化方法,虽然可以通过不断试错提升个体收益,但很容易陷入局部最优状态,当对手策略动态变化时,无法稳定保障整个系统的长期整体社会福利。如何在多轮动态博弈中实现全局、稳定的社会福利管控,一直是分布式系统与空间众包领域的核心难题。
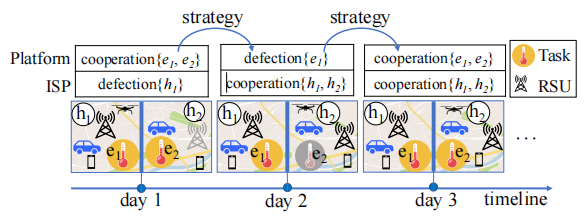
空间众包中的迭代博弈场景示意
针对这一行业难题,研究团队将零行列式(Zero-Determinant,ZD)策略理论引入空间众包博弈场景,创新性提出ZDSC(空间众包零行列式)策略。该策略通过数学推导建立博弈双方收益的线性约束关系,能够单方面控制系统整体的社会福利水平,且控制效果不受对手策略变化的影响。
研究团队基于罗马城市真实出租车轨迹数据集开展了大量仿真实验,将ZDSC策略与全合作、全背叛、随机策略、以牙还牙、强化学习等七类经典策略进行了全面对比验证。实验结果表明,无论对手采用固定策略还是自适应强化学习策略,ZDSC策略都能将系统整体长期社会福利稳定维持在稳定可控的较大值。解决了传统强化学习策略易陷入局部最优、鲁棒性不足的问题。
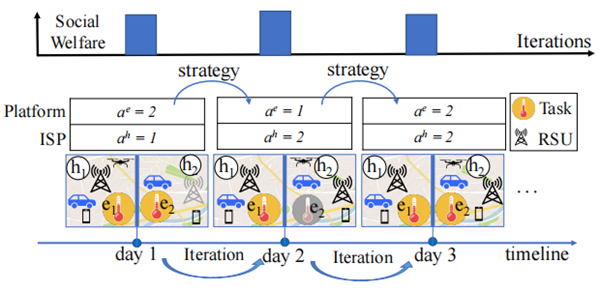
空间众包社会福利控制原理示意
IEEE Transactions on Parallel and Distributed Systems(简称TPDS)是并行与分布式计算领域公认的国际顶级期刊,是中国计算机学会(CCF)推荐的计算机体系结构方向A类期刊,覆盖分布式系统、并行计算、网络协议、边缘计算等多个研究方向,在学术界和工业界都具有极高影响力。
本次研究首次在空间众包场景下系统验证了零行列式策略对强化学习策略的对抗优势,完整建立了迭代博弈下的社会福利控制理论框架,为空间众包系统优化、分布式多智能体调度提供了全新的技术路径。该成果是中国电信云计算研究院在分布式智能与博弈论交叉领域的重要产学研进展,后续将进一步推动相关理论在云边协同计算、分布式智能调度等实际场景中的落地应用。
中国电信云计算研究院北京总部(北京市海淀区学院路42号)
中国电信云计算研究院上海分部(上海市浦东新区世纪大道211号)
京公网安备11040140060 | 京ICP备12007914号 增值电信业务经营许可证A2.B1.B2-20090001


近日,由电子科技大学、成都信息工程大学、中国电信云计算研究院联合完成的研究成果《When Reinforcement Learning Meets Zero-Determinant: Social Welfare Control in Iterated Game under Spatial Crowdsourcing》,被计算机体系结构与并行分布式计算领域CCF A类顶级学术期刊IEEE TPDS正式录用。
科研团队在中国电信首席科学家、云计算研究院院长吴杰教授的指导下开展研究,核心成员包括电子科技大学顾记清博士(现任职于成都信息工程大学)、宋超副教授、鲁力教授和刘明教授。
空间众包是物联网时代的典型感知模式,依托海量移动设备的分布式传感器能力,可实现城市环境监测、交通信息采集、公共服务分发等广泛应用。在完整的空间众包体系中,众包平台负责调度感知任务,网络服务商通过路侧通信单元提供数据传输能力,双方多轮独立决策、相互影响,构成了典型的迭代博弈场景,博弈策略直接决定了整个系统的数据服务质量与整体运行效益。
传统基于强化学习的博弈优化方法,虽然可以通过不断试错提升个体收益,但很容易陷入局部最优状态,当对手策略动态变化时,无法稳定保障整个系统的长期整体社会福利。如何在多轮动态博弈中实现全局、稳定的社会福利管控,一直是分布式系统与空间众包领域的核心难题。
空间众包中的迭代博弈场景示意
针对这一行业难题,研究团队将零行列式(Zero-Determinant,ZD)策略理论引入空间众包博弈场景,创新性提出ZDSC(空间众包零行列式)策略。该策略通过数学推导建立博弈双方收益的线性约束关系,能够单方面控制系统整体的社会福利水平,且控制效果不受对手策略变化的影响。
研究团队基于罗马城市真实出租车轨迹数据集开展了大量仿真实验,将ZDSC策略与全合作、全背叛、随机策略、以牙还牙、强化学习等七类经典策略进行了全面对比验证。实验结果表明,无论对手采用固定策略还是自适应强化学习策略,ZDSC策略都能将系统整体长期社会福利稳定维持在稳定可控的较大值。解决了传统强化学习策略易陷入局部最优、鲁棒性不足的问题。
空间众包社会福利控制原理示意
IEEE Transactions on Parallel and Distributed Systems(简称TPDS)是并行与分布式计算领域公认的国际顶级期刊,是中国计算机学会(CCF)推荐的计算机体系结构方向A类期刊,覆盖分布式系统、并行计算、网络协议、边缘计算等多个研究方向,在学术界和工业界都具有极高影响力。
本次研究首次在空间众包场景下系统验证了零行列式策略对强化学习策略的对抗优势,完整建立了迭代博弈下的社会福利控制理论框架,为空间众包系统优化、分布式多智能体调度提供了全新的技术路径。该成果是中国电信云计算研究院在分布式智能与博弈论交叉领域的重要产学研进展,后续将进一步推动相关理论在云边协同计算、分布式智能调度等实际场景中的落地应用。

